



新闻资讯


TF-QFLUX GPU 求解器发布:实现“以一当百”的算力优势
产品结构越来越复杂,精度要求越来越严格,仿真规模也跟着水涨船高——网格量从千万级迈向上亿。仿真工程师们渐渐发现,面对一个上亿网格的外流场算例,最花时间的往往不是建模,而是等待计算结果。
网格划完、模型调好,剩下的时间全交给排队:节点加到几十个,周转时间还是按“天”算;机房、功耗、运维,成本也随之放大。
TF-QFLUX GPU 求解器应运而生:核心场数据和整条求解流程尽可能留在 GPU 上完成,不改变物理模型、不改变隐式求解路线、不改变工程师的工作流——速度提升一个量级,成本下降一个台阶,已有的工作内容一样都不用改。
快>单卡等效 200+ CPU 核,6 卡等效 1800+ 核 *
省>硬件采购成本最高降约 70%,云计算成本最高降约 80%
稳>隐式求解不变、工作流不变、结果与 CPU 版一致
*中小规模算例采用单卡测试,亿级网格以上大规模算例采用6卡并行测试。
01网格越算越大,算力的账也越算越贵
汽车外流场、风噪、船舶水动力、旋转机械……这些工程问题正同时朝三个方向走:更高的网格分辨率、更复杂的流动结构、更多的设计方案。模型从千万网格迈向亿级网格之后,CPU 集群面对的就不只是"单次算得久"——节点数量、网络互连、机房空间、功耗和运维成本,会一起被放大。
更关键的是,CFD 的价值最终落在设计决策上。一次计算快几倍,意味着同一个开发窗口里可以多验证几个方案、可以把瞬态统计时长拉够,或者干脆把更高分辨率的模型提前带进迭代。
对工程团队来说,真正重要的指标从来不是峰值算力,而是解决问题要多久、每次有效仿真要花多少钱。
这也是为什么推出GPU求解器不只是更换了运行求解器代码的硬件。非结构网格上的稀疏线性代数、场变量更新、大量重复计算,同时受限于内存带宽、并行规模和数据传输效率。近年 GPU 的显存容量、显存带宽与通用并行计算生态持续成熟,让越来越多 CFD 核心计算可以长期驻留在本地GPU上完成。
而真正决定最终加速效果的,不是某一个线性求解器快多少,而是整条流程能不能减少 CPU↔GPU 的数据往返、削减小算子的启动与同步开销,并在多 GPU 下保持高效通信。TF-QFLUX GPU 正是围绕这件事,把求解执行链重新梳理了一遍。
02不把 GPU 当"局部加速器",而是端到端执行
TF-QFLUX GPU 采用端到端 GPU 执行思路:核心场数据处理和求解全流程尽可能保持在本地设备上完成。
对高频场运算,通过计算融合与执行优化,减少中间数据访问、kernel 启动和同步开销;在线性系统求解上,覆盖 AMG、多种 Krylov 子空间方法以及常用预条件算法,为压力、速度等关键方程提供高效求解能力。
同时支持单 GPU 与多 GPU 并行架构,把现代 GPU 的高吞吐能力真正用满,为亿级网格规模的 CFD 仿真提供更高效、也更具成本优势的方案。
一句话:在 TF-QFLUX GPU 里,GPU 不是"加速插件",而是主计算平台。
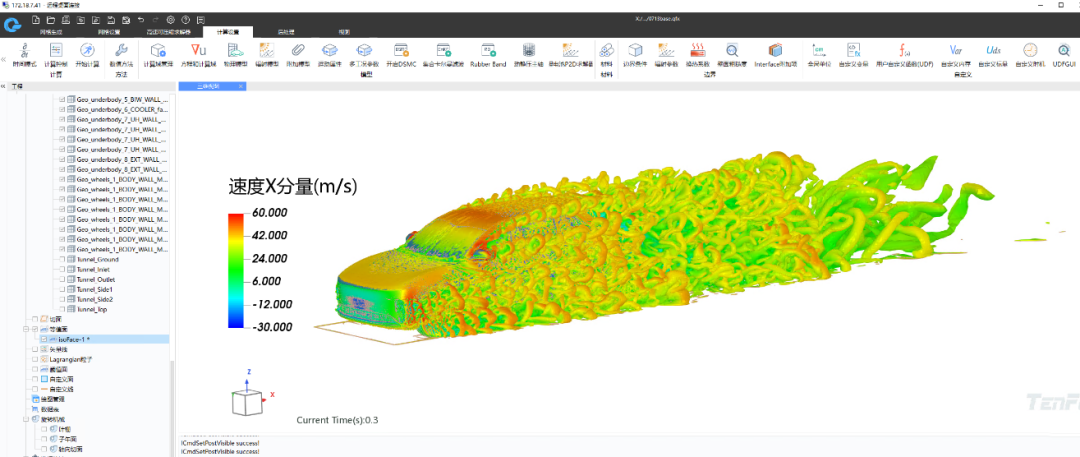
使用TF-QFLUX GPU版进行亿级网格的风噪仿真
03提速的前提,是方法没变:仍然是隐式求解
最重要的一点是TF-QFLUX GPU 版不是靠改物理模型、简化求解流程或降低工程标准换来的性能。
它延续原有的隐式求解架构,只是把核心计算路径迁移到GPU 平台——用 GPU 加速线性系统求解、预条件计算和高频场运算,同时保留原有数值方法、收敛策略和工程工作流。
也就是说,工程师不需要为了用上GPU,去改时间步设置、改模型参数、改边界条件,或者改自己的工程判断标准。
04流程不变,速度提升,结果一致
对已有 TF-QFLUX 用户来说,GPU 化意味着不用重新学一套软件,也不用重新准备工程模型。在当前 GPU 支持范围内,原有工程文件、网格、物理设置、监控量和后处理流程都能直接沿用——CPU 与 GPU 的区别,只是求解执行后端不同。
验证结果也支持这一点:在压力场、速度场、流场分布、气动力性能以及流体噪声等关键工程指标上,GPU 版与 CPU 版保持高度一致,能够稳定复现 CPU 版本的计算结果与工程规律。
已经在 CPU 版上验证通过的算例,可以直接迁移到 GPU 平台。稳定性与可信度不变,求解时间大幅缩短,设计人员就能多做几轮方案迭代、更快完成参数优化。
05GPU版能做什么
TF-QFLUX GPU 版面向航空航天、汽车、能源等领域的典型工业仿真需求,支持从稳态工程分析到瞬态过程模拟,覆盖外气动、流体噪声等关键应用场景。
湍流计算方法上,覆盖RANS、脱体涡与 LES 三个层次:
lRANS 模型:S-A、k-ε、k-ω SST、v2-f 等常用模型
l脱体涡模型:DES、DDES、IDDES 等脱体涡模拟方法
lLES 模型
从常规气动设计,到复杂分离流与气动噪声预测,都能覆盖。
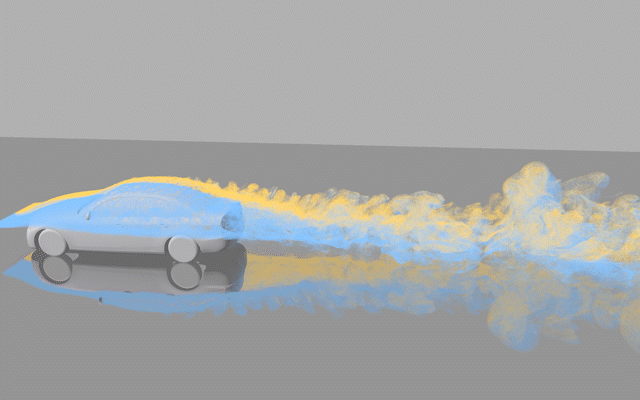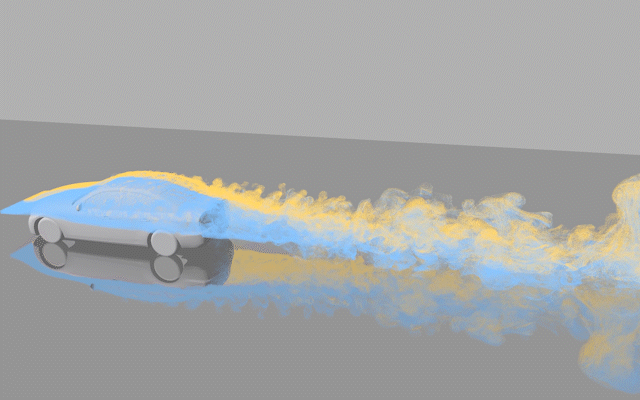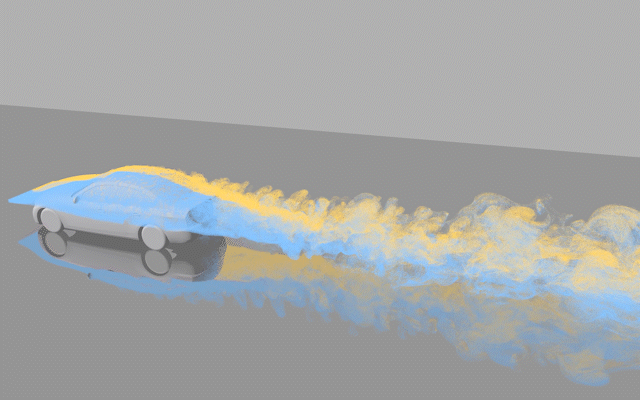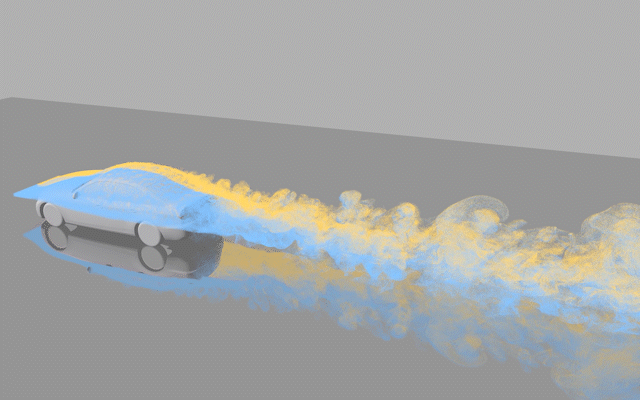
一亿网格DrivAer汽车风噪算例——基于无质量示踪粒子的瞬态湍流结构与尾迹演化可视化
06实测:从 500 万网格到 1 亿网格
我们在多类典型流动算例上验证了 GPU 版本,包括 Ahmed Body 风阻、Suboff 流阻、轴流风机和 DrivAer 风阻风噪,测试覆盖 500 万至 1 亿网格。
中小型算例(500 万 – 2500 万网格)
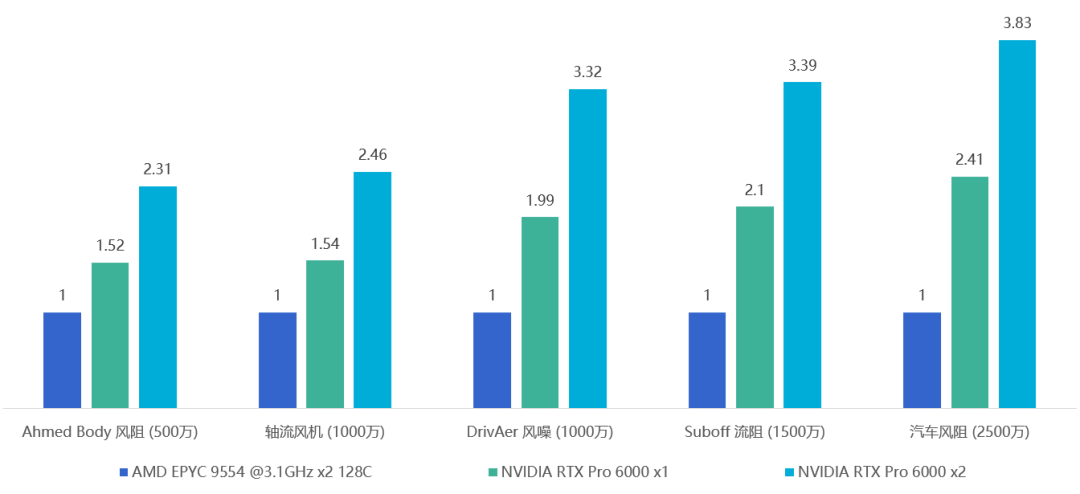
500万 – 2500万网格算例计算效率(纵轴为加速比)
单张 NVIDIA RTX Pro 6000 的整体效率,约为 128 个 AMD EPYC 9554 @3.1GHz CPU 核的 1.5~2.4 倍;双卡约为 2.3~3.8 倍。换算成等效吞吐,单卡约对应 200~300 个 CPU 核,双卡约对应 300~500 个 CPU 核。
按中小型典型工程算例的综合吞吐来算:
1 张 NVIDIA RTX Pro 6000 > 200 个 AMD EPYC 9554 @3.1GHz 核心
亿级算例(1 亿网格 DrivAer 基准)
亿级非结构网格外流场,是衡量通用 CFD GPU 求解能力非常直接的一把尺子:既考验线性求解器和场运算吞吐,也考验显存容量、数据驻留以及长时间计算的稳定性。
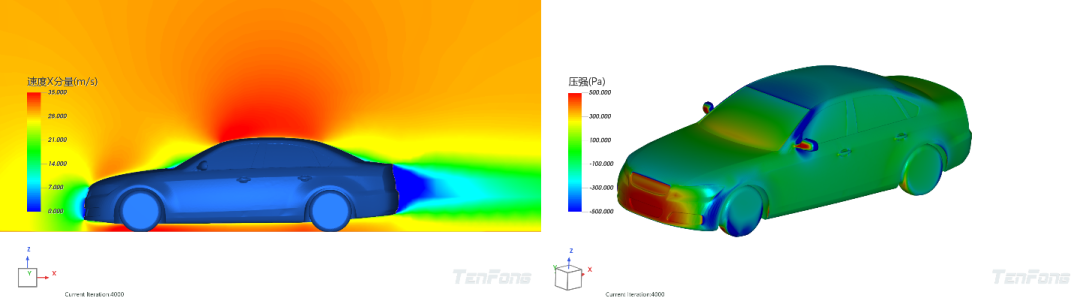
1亿网格 DrivAer 风阻切平面/压强云图
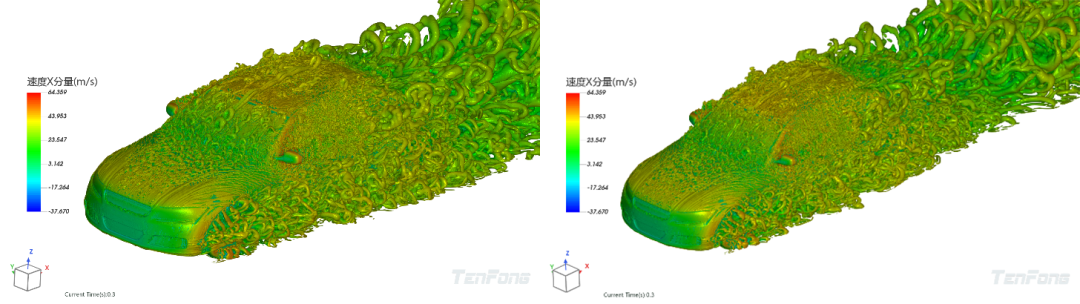
1 亿网格汽车风噪计算结果(左侧为CPU结果,右侧为GPU结果)
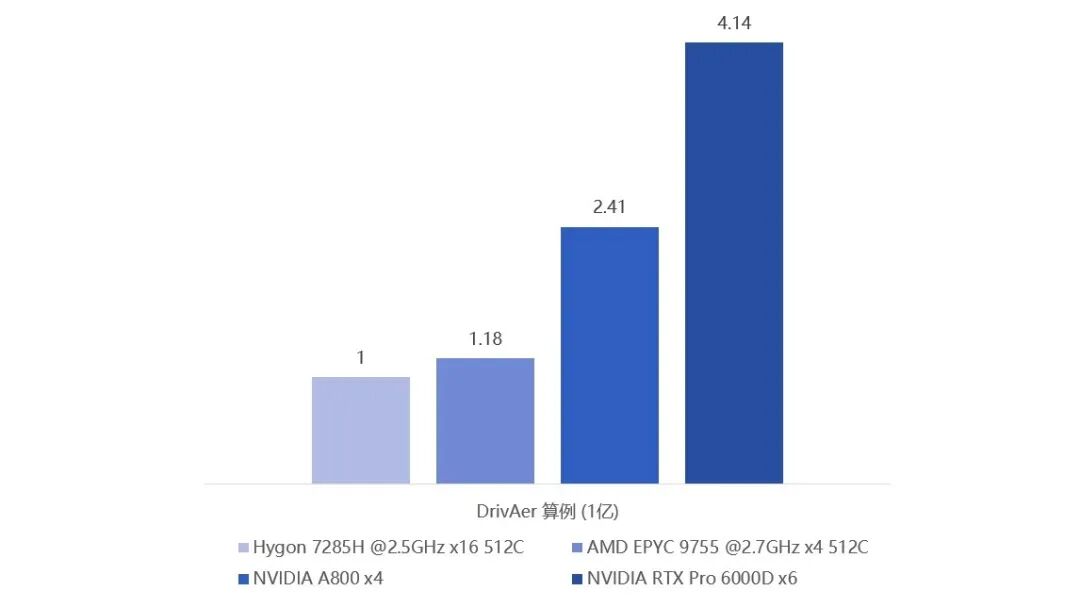
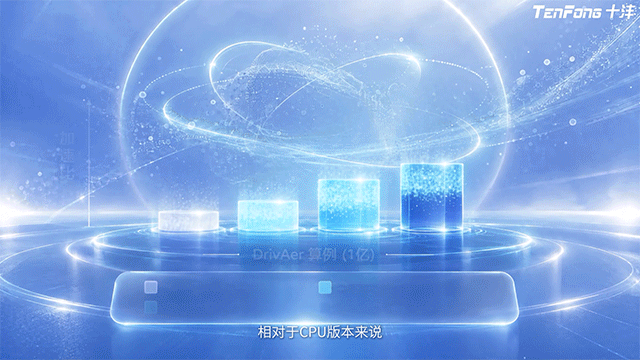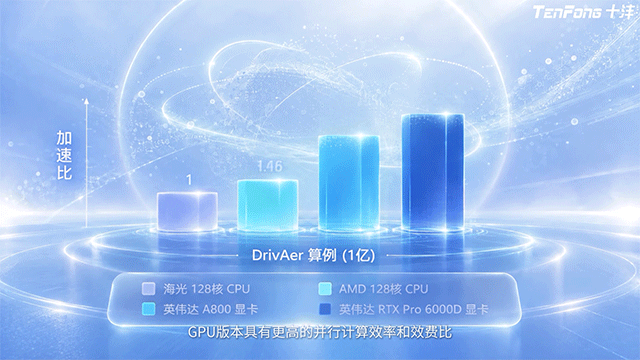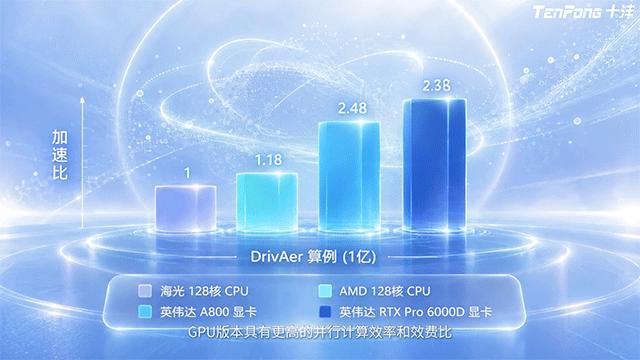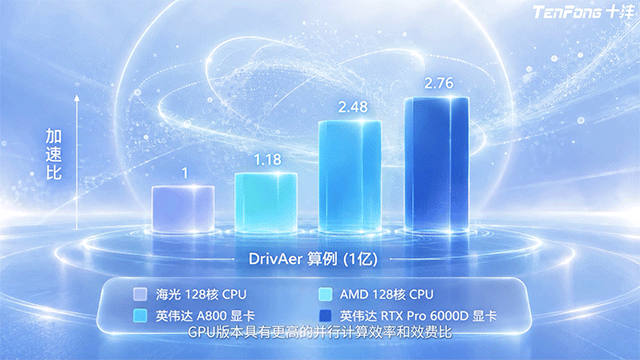
1 亿网格 DrivAer 计算效率(纵轴为加速比)
在这项汽车外部空气动力学基准测试中,相同配置、且计算结果与 CPU 及实验值均一致的前提下,6 张 NVIDIA RTX Pro 6000D 显卡的性能,是 512 核的 AMD EPYC 9755 @2.7GHz 集群的约 3.5 倍。在显存充裕的情况下,网格量越大,GPU相比CPU的优势越明显。
按该 1 亿网格 DrivAer 基准的综合吞吐来算:
6 张 NVIDIA RTX Pro 6000D > 1800 个 AMD EPYC 9755 @2.7GHz 核心
07更多的用户价值:真正改变的是每次仿真的成本
当单卡已经达到数百 CPU 核级的等效求解吞吐,硬件规划的方式也会跟着变。
过去为了压缩一个大算例的周转时间,通常要加 CPU 节点、加并行互连、加机柜资源;现在更高的计算密度被收进更少的节点里——一台工作站,或一台多卡服务器,就能承担过去需要 CPU 集群才能完成的任务。
对企业来说,这笔账要按总拥有成本来算,而不是只看单颗芯片的价格:采购成本、节点数量、网络互连、电力与散热、机房空间、日常运维,全都在同一张表上。
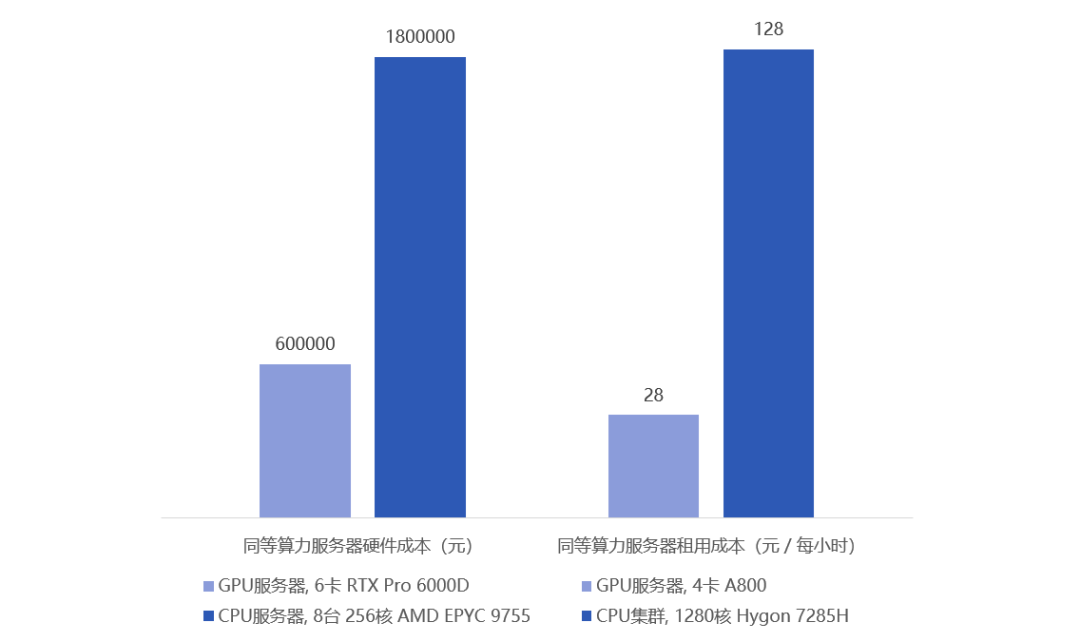
CPU 服务器和同等 GPU 服务器的计算成本
在典型算力匹配场景下:
硬件采购成本最高可降低约 70%
云计算成本最高可降低约 80%
还有一项常被忽略的收益:同一个研发周期里能完成更多设计迭代。这部分时间价值,往往比硬件本身更值钱。
08更多物理模型、更高多 GPU 扩展效率、更多国产 GPU
首版 TF-QFLUX GPU 求解器解决了最核心的问题:让通用流体问题跑上 GPU,并且让现有工作流平滑迁移。
接下来,TF-QFLUX 会继续扩展多相流等复杂物理模型,并持续优化现有模型与多 GPU 扩展效率。
同时,TF-QFLUX 将支持更多异构硬件后端。GPU 求解器的架构设计从一开始就把"支持众多国产 GPU"作为关键目标:采用模块化设计理念,把不同 GPU 抽象为统一的后端模型,从而快速适配更多国产 GPU 平台。
我们相信,GPU 不应只是求解器里的"加速选项",而会逐步成为工业 CFD 的计算底座。TF-QFLUX 正走向面向异构计算时代的新一代工业仿真平台:更快、更低成本,也给用户更多硬件选择。
最新资讯